Presupuestos, facturas, cuadros de precios unitarios (BPU), descomposiciones del precio global (DPGF), contratos marco, listas de precios. Sacar un precio unitario, un descuento, una cantidad, una fecha de vencimiento de un documento que nunca se diseñó para que lo leyera una máquina. Esta etapa es el cimiento silencioso del control de compras, finanzas y contabilidad. Cuando se hace deprisa, todo lo que sigue (la conciliación, la detección de anomalías, la decisión) queda en el aire.
La mayoría de las organizaciones invierten en herramientas de análisis y de reporting sofisticadas, pero descuidan el eslabón que las alimenta. Y un dato mal extraído no produce un análisis degradado: produce un análisis falso, con la misma apariencia de fiabilidad que un análisis correcto. Eso es precisamente lo que hace que la extracción de datos sea a la vez técnica y estratégica.
Extracción de datos: ¿de qué hablamos realmente?
La extracción de datos consiste en transformar un documento no estructurado (un PDF, una hoja de cálculo, un escaneo, un correo electrónico de resumen) en información estructurada, explotable y comparable. En concreto, se trata de identificar en un documento los elementos determinantes (naturaleza de la prestación, cantidades, precios unitarios, descuentos, condiciones de pago, fechas de vencimiento, referencias contractuales) y de devolverlos en una forma lógica, lista para cruzarse con otras fuentes.
Hay que distinguir la extracción de las etapas vecinas. La captura consiste en recuperar el documento. La clasificación consiste en identificar su tipo (¿es un presupuesto, una factura, un BPU?). La conciliación consiste en comparar los datos extraídos con los referenciales. La extracción es la bisagra entre el documento en bruto y la inteligencia: decide la calidad de todo lo que viene después. Una conciliación perfecta sobre datos mal extraídos sigue siendo una conciliación falsa.
Por qué la extracción es un problema más difícil de lo que parece
La primera intuición es pensar que leer un documento es trivial. Un humano lo hace en unos segundos. Eso es justamente lo que oculta la dificultad real del problema a gran escala.
La heterogeneidad de los formatos
No existe ningún estándar legal que imponga la estructura de un presupuesto o de una factura de proveedor. Cada emisor aplica su propia maquetación, sus propias denominaciones, sus propios códigos de artículo. El mismo producto puede aparecer bajo tres nombres distintos según tres proveedores. Un presupuesto puede ser un PDF generado por un ERP, una tabla de Excel maquetada a mano o un simple correo electrónico. Antes de comparar dos documentos, hay que traducirlos a un lenguaje común, algo que el ojo humano hace sin pensarlo pero que un sistema debe aprender a reproducir de forma fiable y repetible.
La densidad y la variabilidad documental
Un BPU (cuadro de precios unitarios) puede contener varios cientos de líneas, cada una con su código, su unidad de medida y su precio. Una DPGF (descomposición del precio global y a tanto alzado) sigue su propia lógica en cada contrato. Extraer limpiamente cuatrocientas líneas de prestación, sin olvidar ni una y sin confundir una cantidad con un importe, supera rápidamente la capacidad de un tratamiento manual atento, sobre todo con presión de tiempo.
El dato no estructurado
La mayor parte de la información que circula entre un proveedor y una dirección de compras no está ordenada en casillas claras. Está diluida en texto libre, tablas sin bordes, anotaciones, condiciones particulares expresadas en lenguaje natural. Un descuento puede figurar en una cláusula en lugar de en una columna. Unos gastos accesorios pueden aparecer bajo una denominación que no corresponde a nada del presupuesto inicial. Extraer no se limita, por tanto, a copiar cifras: hay que entender el contexto para saber qué cifra cuenta.
No todos los documentos son iguales: la escala de complejidad
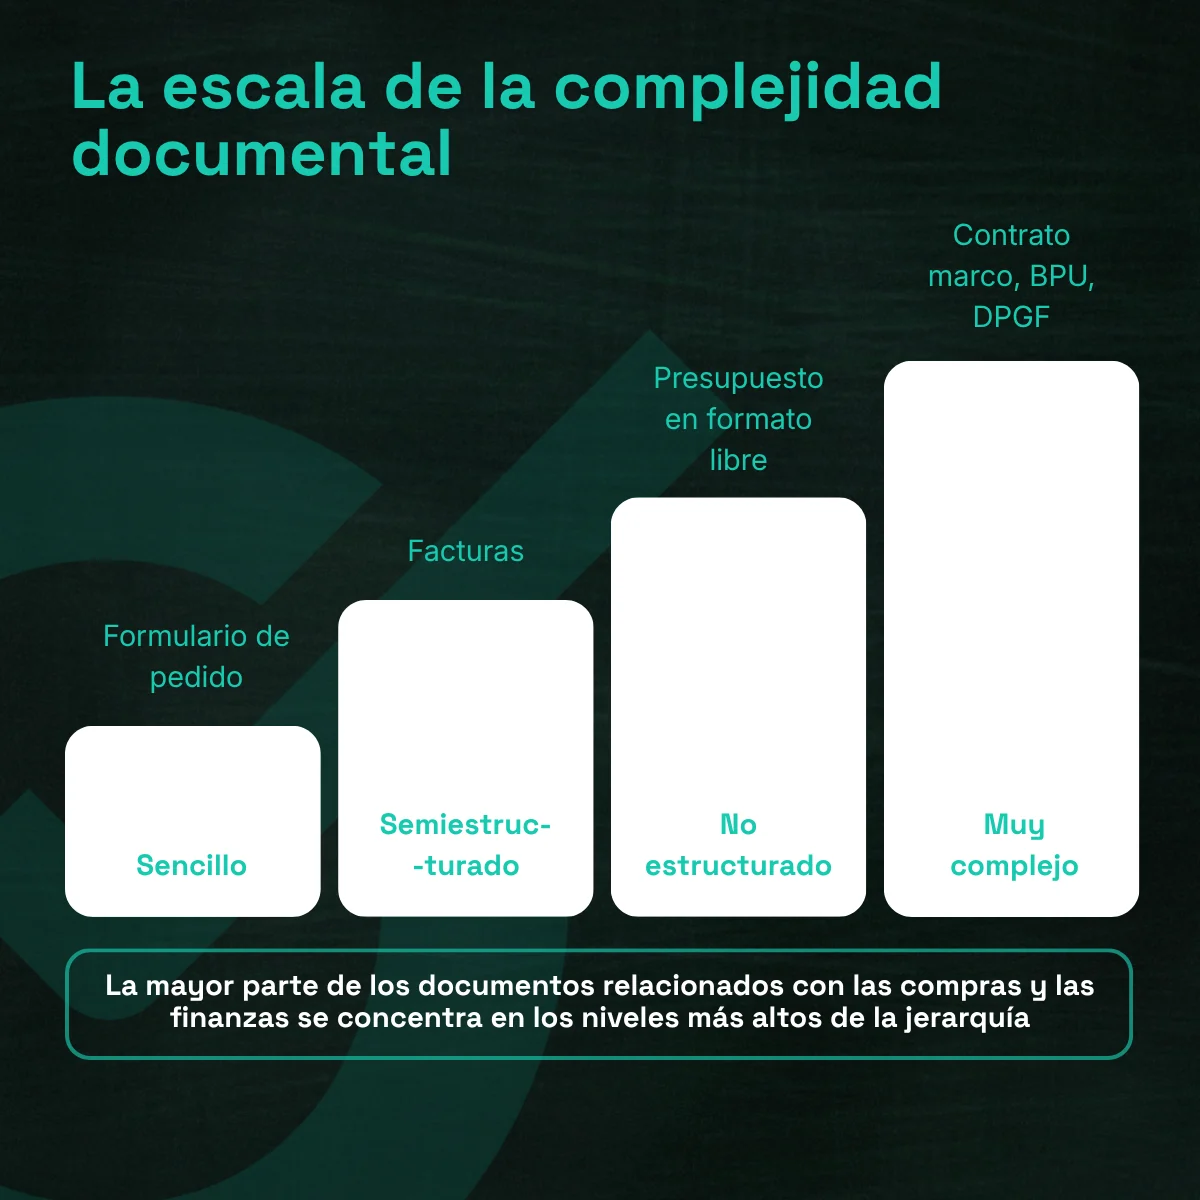
Entender por qué la extracción se resiste a la automatización supone admitir que los documentos no están todos en el mismo nivel de dificultad. Cuanto más variable es un documento en su forma y más rico en su contenido, más exigente resulta la extracción. Esta realidad puede representarse como una escala de complejidad creciente. El contexto general no juega a favor de las empresas: según IDC, cerca del 90 % de los datos de empresa no están estructurados, un orden de magnitud confirmado por otros actores del sector como Databricks, que los sitúan entre el 80 % y el 90 %.
En el primer nivel están los documentos sencillos y estructurados, como un formulario de pedido estandarizado o una hoja de cálculo normalizada. Su forma es previsible y su extracción, relativamente directa. En el segundo nivel, los documentos semiestructurados (facturas, formularios) ofrecen algunas referencias de estructura, pero cada emisor aplica su propia presentación. En el tercer nivel, los documentos no estructurados (presupuestos en formato libre, listas de precios, estados financieros) mezclan texto y cifras sin una lógica común de un proveedor a otro. En la cúspide, los documentos de muy alta complejidad (contratos marco, BPU, DPGF, pliegos técnicos) acumulan cientos de líneas, cláusulas en lenguaje natural y condiciones indexadas.
El punto decisivo para las funciones de compras, finanzas y contabilidad es el siguiente: la mayor parte de los documentos que tratan a diario se concentra en la parte alta de esta escala. No dominan los casos fáciles, sino los complejos. Precisamente por eso, una extracción pensada para documentos sencillos se derrumba ante los documentos reales.
Del OCR a la IA agéntica: la larga trayectoria de la extracción documental
La extracción automática de datos no nació con la inteligencia artificial reciente. Sigue una larga trayectoria, en la que cada etapa ha ido empujando un poco más la rigidez de la plantilla.
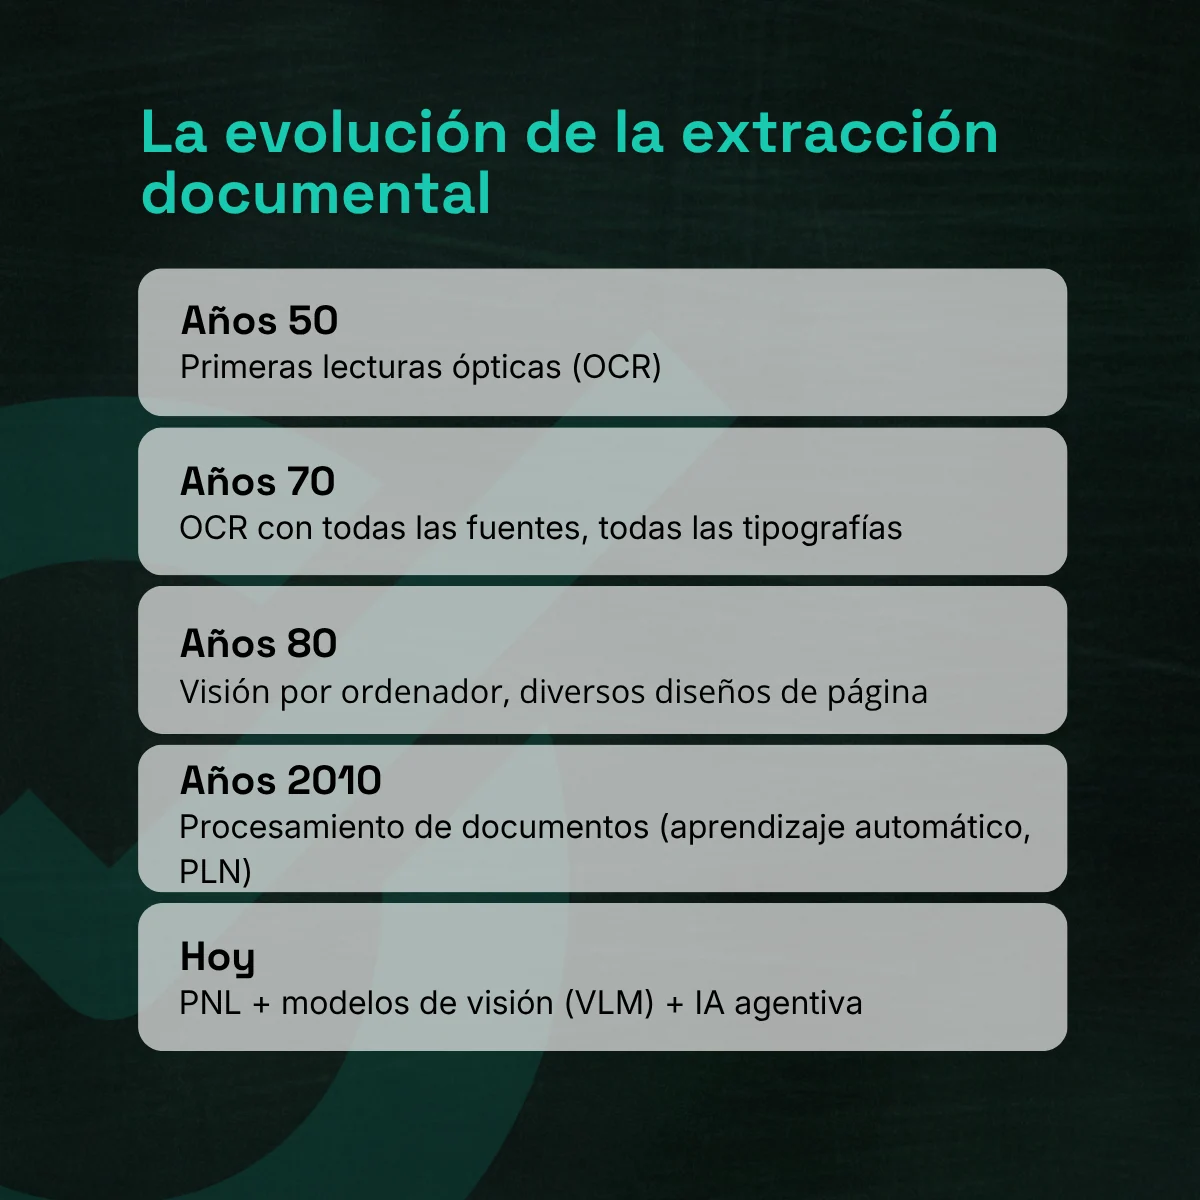
Desde los años 50, las primeras lecturas ópticas (OCR) convierten documentos mecanografiados en datos de máquina. En los años 70 aparece el OCR omnifuente, capaz de reconocer caracteres sea cual sea la tipografía. A partir de los años 80, los algoritmos de visión por ordenador permiten tratar diseños de página más variados. En los años 2010 surge una primera generación de herramientas de procesamiento documental, que superpone interfaces cómodas al OCR y empieza a movilizar el aprendizaje automático y el procesamiento del lenguaje natural (PLN) para ganar flexibilidad.
El hilo conductor de esta historia es claro: cada generación ha buscado liberarse de la restricción del modelo predefinido, esa fragilidad que hace que un simple cambio de maquetación rompa la extracción. La ruptura actual, impulsada por la combinación del PLN, los modelos de visión (VLM) y la IA agéntica, prolonga esa trayectoria cruzando un umbral: leer un documento sin plantilla, entendiendo su contenido en lugar de calcarlo.
Los enfoques clásicos y su techo de cristal
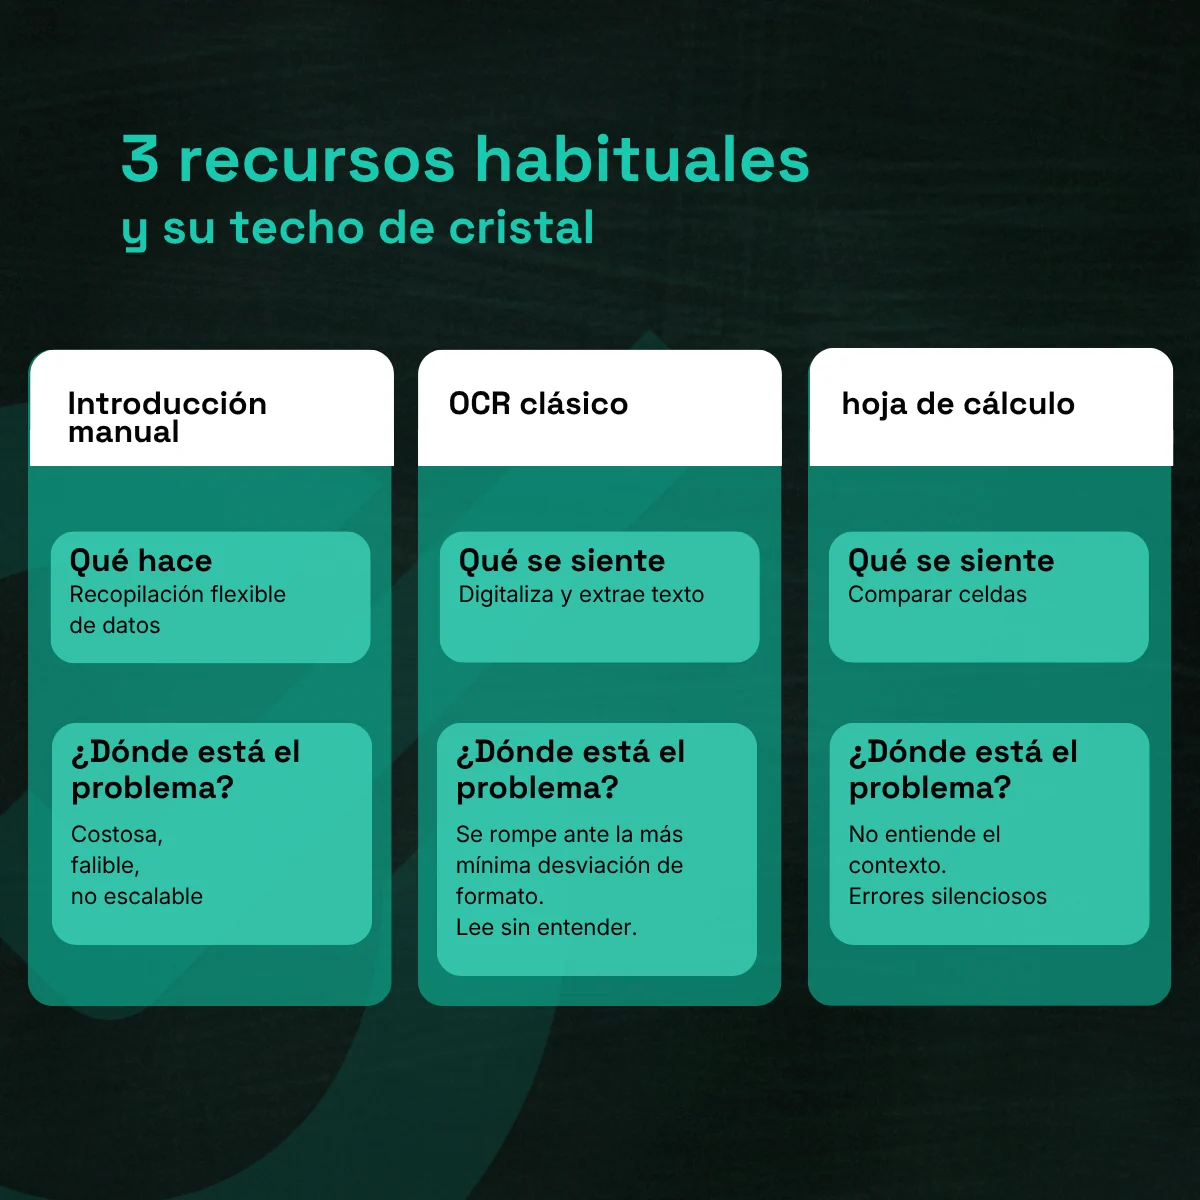
Ante este reto, las organizaciones han recurrido históricamente a tres recursos, y cada uno choca con el mismo límite.
La introducción manual
Sigue siendo la norma en muchos departamentos. Es flexible, pero costosa y falible. Entre el 40 % y el 70 % del tiempo de un comprador puede quedar absorbido por el tratamiento documental, con una parte significativa de reintroducción de datos. Cada introducción es una ocasión para colar una inexactitud (una referencia mal codificada, un descuento redondeado, un decimal desplazado) que después contaminará todos los análisis posteriores.
El OCR clásico
El reconocimiento óptico de caracteres digitaliza un documento y extrae su texto. Es un primer paso útil, pero se queda en la superficie. El OCR basado en plantillas rígidas funciona mientras el documento respete exactamente la plantilla esperada. El más mínimo cambio de maquetación rompe la extracción. Sobre todo, el OCR lee sin entender: no sabe que el precio por kilo que acaba de leer debe cotejarse con una lista de precios negociada seis meses antes, ni que una denominación distinta remite a la misma prestación. Traslada el problema a una hoja de cálculo; no lo resuelve.
La hoja de cálculo
Excel sigue siendo el refugio universal. Compara celdas, no contextos. No detecta que una línea «manipulación incluida» corresponde a «portes gratuitos» en otro documento, y un simple error de fórmula se propaga en silencio por todos los cálculos que dependen de él. Con poco volumen, ayuda. En cuanto aumentan el número de documentos y la complejidad de las condiciones, alcanza sus límites estructurales.
El punto común de estos tres enfoques: tratan la extracción como una operación mecánica, cuando es una operación de interpretación.
El reto de negocio: lo que una extracción fiable hace ganar de verdad
Centrar la atención en la extracción no es un refinamiento técnico. Ahí se juega una parte concreta del margen.
El tiempo devuelto a los equipos
Automatizar la extracción es liberar las horas que hoy se dedican a leer, reintroducir y normalizar documentos. Ese tiempo no es tiempo estratégico: es tiempo de verificación mecánica pagado al precio de un experto. Al recuperarlo, los equipos de compras y finanzas pueden reasignarlo a la negociación, a la relación con el proveedor y al análisis, es decir, a lo que realmente crea valor.
La fiabilidad de las decisiones
Una extracción fiable produce una base de datos comparable. Sin ella, las decisiones de compra estructurantes (renovar un contrato, consolidar volúmenes, renegociar una tarifa) se toman sobre datos parciales o reconstruidos a mano. Con ella, cada decisión se apoya en lo que los documentos contienen realmente, y no en lo que se supone que contienen.
La detección posterior
La extracción condiciona mecánicamente la calidad de la detección de desviaciones. Un descuento no extraído es un descuento que nunca se controlará. Una línea de gastos mal interpretada es una desviación que pasará desapercibida. Y los márgenes de error se sitúan entre el 3 % y el 5 %. Precisamente porque la extracción se hace fiable antes, la detección de desviaciones documentales puede alcanzar una precisión elevada después. Hoy, uno de cada dos documentos de proveedor sigue escapando al control, y una extracción deficiente suele ser la primera causa.
Conclusión
La extracción de datos es la pieza más discreta del control de compras y finanzas y, sin embargo, la que decide todo lo demás. No se ve en los cuadros de mando, no es objeto de proyectos estratégicos dedicados, y justamente por eso constituye un punto ciego costoso. Mientras el dato entre en el sistema por una introducción manual falible o una digitalización ciega, ninguna herramienta de análisis posterior podrá compensar ese defecto de cimentación.
Hacer fiable la extracción es negarse a construir decisiones sobre datos inciertos. Es también la primera condición para recuperar tiempo, asegurar el margen y devolver a los equipos la visibilidad que nunca han tenido sobre lo que sus documentos contienen de verdad.
Descubra Zylio con sus propios documentos.